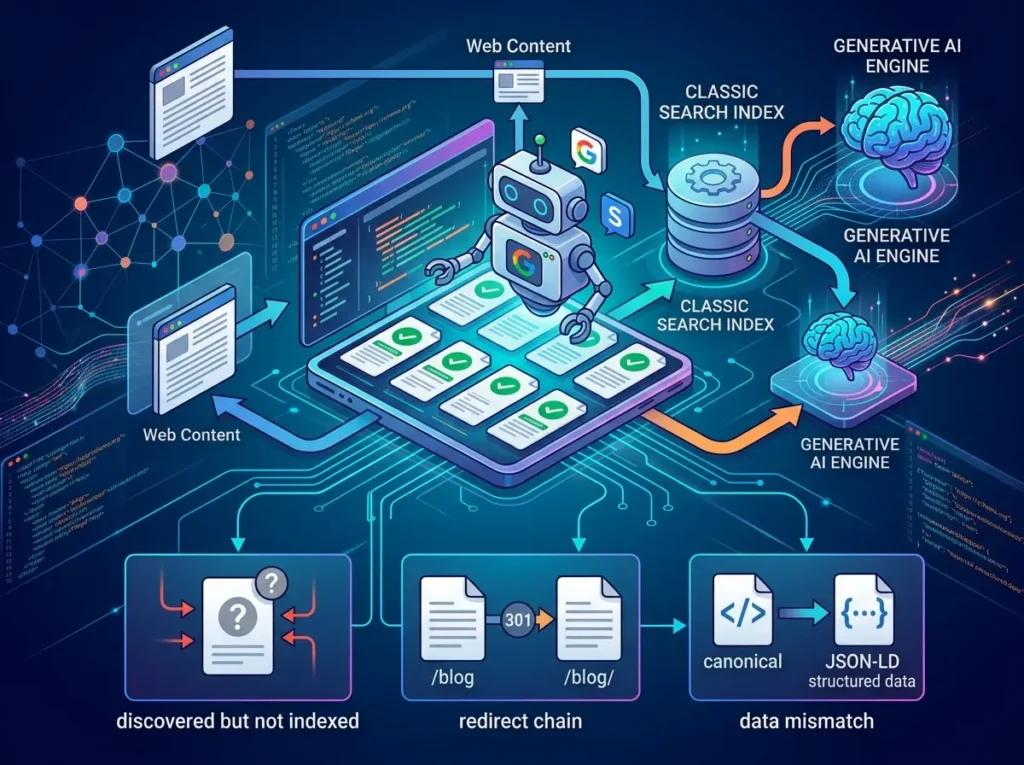
Si parla molto di come farsi citare dagli assistenti AI e molto poco del prerequisito che rende possibile tutto il resto. Le funzionalità AI della Ricerca attingono all’indice classico: se Google non tiene una pagina, quella pagina non entra in nessuna risposta. Ecco cosa abbiamo trovato guardando un sito in questa chiave.
La documentazione di Google sull’ottimizzazione per le funzionalità AI dice una cosa che dovrebbe spostare le priorità di molti audit: quelle funzionalità pescano dal ranking classico. Non esiste un canale separato, e non esiste un modo per entrare nelle risposte generative saltando l’indice.
Nella stessa pagina Google elenca cosa non ha effetto, e la lista è utile perché smonta parecchio di quello che viene venduto: llms.txt, il chunking dei testi pensato per i modelli, la variazione delle keyword per parlare all’AI, i dati strutturati intesi come chiave d’accesso alle risposte generative. Restano due requisiti concreti, essere indicizzati ed essere idonei allo snippet, e una condizione di contenuto, cioè avere qualcosa di proprio da dire.
Da qui il senso di questo pezzo. Prima di chiedersi come farsi citare, conviene chiedersi se il sito è nelle condizioni di esserlo. Tre esempi da un’analisi recente.
Uno. La pagina che Google trova e decide di non tenere
In Search Console esiste uno stato che merita più attenzione di quella che riceve: Discovered, currently not indexed. Significa che Google conosce l’URL, spesso perché sta nella sitemap, e ha scelto di non indicizzarlo.
Sul sito che stavamo guardando riguardava un articolo con cinque link interni in ingresso, contenuto originale, nessuna direttiva di blocco. Non era un problema di configurazione. Era Google che, su un dominio senza particolare autorità, razionava quello che si teneva.
La conseguenza sul GEO è diretta e spesso ignorata: quella pagina non può comparire in nessuna risposta generativa, indipendentemente da come è scritta. Ottimizzarne il contenuto per l’AI sarebbe stato lavoro buttato.
Il controllo si fa in trenta secondi con l’URL Inspection API, e vale la pena farlo prima di qualsiasi discorso sui modelli. Un dettaglio che fa perdere tempo: l’API vuole l’URL nella forma canonica esatta. Se il sito serve le pagine con la barra finale e la si interroga senza, la risposta è che l’URL è sconosciuto, e sembra un problema di indicizzazione quando è un problema di digitazione.
Due. Centotrenta link interni che passavano da un 301
Sullo stesso sito le pagine rispondevano 200 all’indirizzo con la barra finale e 301 a quello senza. I link interni puntavano quasi tutti alla seconda forma.
Il conteggio: centotrenta link su settecentododici. Un crawler che ne segue uno fa due richieste invece di una.
Su un sito con autorità da vendere è un dettaglio trascurabile. Su un dominio che si vede già negare l’indicizzazione di alcune pagine, è metà del budget di scansione speso per arrivare dove si poteva arrivare direttamente.
La verifica è banale e la riporto perché è replicabile su qualsiasi build statica:
grep -rhoE 'href="/(sezione)/[a-z0-9-]+"' dist/ | sort -u
Prima di sostituire in massa conviene però controllare che ogni destinazione risponda 200 nella forma con la barra. Nel nostro caso erano ventisette destinazioni uniche, verificate una per una prima di toccare il codice: un sed su cinquantatré file senza quel controllo è il modo più rapido per trasformare centotrenta redirect in centotrenta errori.
Tre. Schema e canonical che dichiaravano due URL diverse
Questo è il punto che mi ha sorpreso di più, perché era invisibile a occhio.
Il template dell’articolo costruiva a mano la URL usata nei dati strutturati:
const url = `${site}/magazine/${slug}`;
Il canonical invece veniva generato dal framework a partire dal path reale, quindi con la barra finale. Il risultato era che BlogPosting.url, mainEntityOfPage.@id e l’ultimo elemento del BreadcrumbList dichiaravano un indirizzo, e il ne dichiarava un altro, sulla stessa pagina.
Google normalizza e non è un errore fatale. Ma è un segnale sporco su un sito che ha già problemi di copertura, ed è il tipo di incoerenza che si moltiplica su ogni articolo senza che nessuno se ne accorga, perché nessun tool la segnala in modo evidente e la pagina funziona perfettamente per gli utenti.
Il controllo che ha senso automatizzare è il confronto diretto: estrarre dal build il canonical e la url di ogni JSON-LD e verificare che coincidano.
Cosa c’entra tutto questo con l’AI
C’entra perché è il presupposto. Una pagina non indicizzata non entra nelle risposte generative. Una pagina che il crawler raggiunge sprecando richieste viene visitata meno spesso. Una pagina che dichiara due identità diverse consolida più lentamente i propri segnali.
Nessuna di queste tre cose si risolve scrivendo contenuti migliori, e nessuna compare nei pacchetti di ottimizzazione per gli assistenti AI che circolano, perché è lavoro poco raccontabile.
Quando l’igiene tecnica è a posto, il resto è quello che Google dice esplicitamente: contenuto specifico, esperienza diretta, dati che gli altri non hanno. I modelli non citano chi riassume il consenso, perché riassumere il consenso lo sanno fare da soli.
Ordine dei fattori, in breve. Prima verificare che le pagine siano indicizzate e idonee allo snippet. Poi sistemare i segnali che si contraddicono. Solo dopo ha senso ragionare su come rendere un contenuto citabile, perché prima di allora non c’è niente da citare.